ReLU - Rectified Linear Unit (KI)
Rectified Linear Unit (ReLU) ist eine Aktivierungsfunktion in künstlichen Neuronen, die in künstlichen neuronalen Netzen verwendet werden.
ReLu lässt positive Werte unverändert durch und setzt negative auf 0. Das ist sehr einfach und schnell zu berechnen. Deshalb ist das der Standard in vielen Netzen.
Problem: Bei dauerhaft negativen Eingaben "sterben" Neuronen, weil der Gradient dort 0 ist ("dying ReLU").
Definition
ReLU ist mathematisch definiert als:

- x ist der Input für das Neuron.
- Die Funktion gibt x zurück, wenn x größer als 0 ist.
- Wenn x kleiner oder gleich 0 ist, gibt die Funktion 0 zurück.
Das bedeutet:
- Für negative Eingaben wird der Wert 0 zurückgegeben.
- Für positive Eingaben wird der Wert von x zurückgegeben.
ReLU ist sehr einfach zu berechnen und wird in künstlichen neuronalen Netzen eingesetzt, um das Training effizienter zu machen. Beispielsweise gibt es weniger Probleme mit verschwindenden Gradienten, wie bei der Sigmoid-Funktion.
Vorteile von ReLU
Einfachheit: ReLU ist rechnerisch effizient, da es sich um eine Schwellwert-Berechnung handelt. Der geringe Rechenaufwand beschleunigt das Training mit großen neuronalen Netzen und KI-Modellen.
Nichtlinearität: Damit ein neuronales Netz komplexe Datenmuster lernen und komplizierte Beziehungen erkennen kann, bedarf es einer nichtlinearen Funktion. ReLU ist nichtlinear.
Vanishing-Gradient: ReLU bietet rechnerische Vorteile in Bezug auf die Rückpropagation, da seine Ableitung einfach ist. Das hilft dabei, das Problem des verschwindenden Gradienten (Vanishing-Gradient) zu vermeiden, das ein häufiges Problem bei Sigmoid- oder Tanh-Aktivierungsfunktionen sein kann.
Implementierung zum Ausprobieren
Mit Python lässt sich ReLU sehr leicht implementieren und ausprobieren:
def relu(x):
    """ReLU: Gibt x zurück, wenn x positiv ist, sonst 0."""
    #return x if x > 0 else 0  # vereinfacht
		return max(0, x)

# Beispiel
print(relu(0))    # Ausgabe: 0
print(relu(2))    # Ausgabe: 2
print(relu(-2))   # Ausgabe: 0
Leaky ReLU
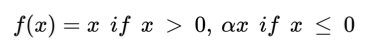
Eine noch einfachere Implementierung löst das Dying-ReLU-Problem. Statt negative Werte komplett abzuschneiden, lässt die Funktion einen kleinen Bruchteil (α gleich z. B. 0.01) durch. So bleibt auch bei negativen Eingaben ein kleiner Gradient erhalten, und Neuronen "sterben" nicht mehr komplett ab.
def leaky_relu(x, alpha=0.01):
    """Leaky ReLU: Wie ReLU, lässt aber für negative x einen kleinen, mit alpha skalierten Wert durch statt hart auf 0 zu setzen."""
    return x if x > 0 else alpha * x
Weitere verwandte Themen:
- Künstliche neuronale Netze (KNN)
- Aktivierungsfunktionen (KI)
- Tanh-Funktion (Tangens hyperbolicus)
- Sigmoid-Funktion
Lernen mit Elektronik-Kompendium.de
Noch Fragen?
Bewertung und individuelles Feedback erhalten
Aussprache von englischen Fachbegriffen

Computertechnik-Fibel
Computertechnik neu verstehen - jetzt in der 6. Auflage
Die Computertechnik-Fibel ist in einer vollständig überarbeiteten 6. Auflage als Buch, eBook und Bundle erschienen.
Statt einzelne Teile zu lernen, entwickelst du ein Gesamtverständnis moderner Computersysteme. Von der Hardware, Betriebssysteme, Virtualisierung, KI und Quantencomputer.
inkl. MwSt. zzgl. Versandkosten
Computertechnik-Fibel
Alles was du über Computertechnik wissen musst.
Die Computertechnik-Fibel ist ein Buch über die Grundlagen der Computertechnik, Prozessortechnik, Halbleiterspeicher, Schnittstellen, Datenspeicher, Laufwerke und wichtige Hardware-Komponenten.
Artikel-Sammlungen zum Thema Computertechnik
Alles was du über Computertechnik wissen solltest.